Co kilka miesięcy pojawia się nowy model AI i za każdym razem słyszymy to samo: jest lepszy od poprzedniego. Zwykle to prawda.
Tylko że „lepszy” to średnia. Nas interesowało, w czym dokładnie nowe modele są lepsze. Czy postęp rozkłada się równo? A może niektóre rodzaje pracy zyskują dużo, a inne prawie nic?
Sprawdziliśmy to na danych z trzech lat, obejmujących 353 modele. W skrócie:
- Nowe modele są lepsze we wszystkim. W żadnej dziedzinie nie widać spadku.
- Ale tempo jest bardzo różne. Najszybciej rosną zadania, w których wynik da się sprawdzić – kod i matematyka. Wolniej to, co wymaga oceny człowieka, na przykład pisanie. Różnica powiększa się z roku na rok.
- Pisanie kreatywne ma dziś około ośmiu miesięcy opóźnienia względem programowania i co roku traci kolejny miesiąc.
- Publiczne benchmarki tego nie wychwycą. Dziewięć na dziesięć wyników dotyczy zadań, które da się automatycznie sprawdzić.
Jeśli w Twojej firmie AI pisze teksty, rozmawia z klientami albo doradza – czyli robi coś, co ocenia się „na wyczucie” – warto to wiedzieć. Kolejna aktualizacja modelu da Ci mniej, niż obiecują nagłówki.
Dlaczego publiczne benchmarki tu nie wystarczą
Modele AI porównuje się zwykle za pomocą benchmarków, czyli standardowych testów, w których każdy model dostaje te same zadania i jest oceniany według tych samych zasad. Benchmarków są setki. Zebraliśmy z nich ponad 90 tysięcy wyników ze 147 rodzin testów.
Kłopot w tym, co właściwie mierzą.

91% wszystkich wyników pochodzi z zadań, które mają poprawną odpowiedź: pytań z wiedzy ogólnej, zadań matematycznych, kodu, który działa albo nie. Pracy otwartej – pisaniu, kompetencjom społecznym, ocenie sytuacji – poświęcone jest zaledwie 9%. Na temat wartości i światopoglądu mamy 29 wyników na 90 tysięcy.
Nikt tego tak nie zaprojektował. Po prostu tak wychodzi taniej. Gdy zadanie ma poprawną odpowiedź, komputer sprawdzi milion rozwiązań praktycznie za darmo. Gdy jej nie ma, każdą odpowiedź musi przeczytać człowiek – albo ocenę zleca się innemu modelowi AI. I tak się właśnie dzieje: 83% wyników z pisania kreatywnego wystawia inny model. Tam, gdzie benchmarki w ogóle zaglądają w pracę wymagającą oceny, AI często ocenia AI.
Efekt jest taki, że porównując modele wyłącznie na benchmarkach, patrzymy na tę część AI, która rozwija się najszybciej. Ta wolniejsza prawie nie trafia do statystyk.
Dlatego potrzebowaliśmy innego źródła danych.
Jak to policzyliśmy
To najważniejsza część, więc opisujemy ją po kolei.
1. Źródło: głosy ludzi. Skorzystaliśmy z LMArena. To publiczny serwis, w którym użytkownik zadaje pytanie i dostaje dwie odpowiedzi od dwóch anonimowych modeli. Wskazuje tę, która bardziej mu odpowiada. Z milionów takich głosów powstaje ranking modeli, działający podobnie jak ranking szachowy. Żaden model AI niczego tu nie ocenia – każdy głos oddaje człowiek.
2. Osobny ranking dla każdej dziedziny. LMArena przypisuje każde pytanie do tematu – programowanie, matematyka, pisanie kreatywne, prawo, medycyna itd. – i dla każdego tematu publikuje osobny ranking. Wzięliśmy pod uwagę 11 dziedzin. Dzięki temu każdy model ma swój profil: jak wypada w kodzie, w pisaniu, w pytaniach prawnych i tak dalej.
3. Bez premii za formę. Ludzie chętniej głosują na dłuższe odpowiedzi, z wypunktowaniami i pogrubieniami. LMArena udostępnia wersję rankingu, z której ten efekt jest odfiltrowany. Korzystaliśmy właśnie z niej, więc model nie zyskuje punktów tylko za to, że pisze więcej albo ładniej formatuje.
4. Każdy model na tle samego siebie. To kluczowy krok. Mocniejszy model wypada lepiej we wszystkim, więc proste porównanie wyników pokazałoby głównie, który model jest silniejszy. Dlatego dla każdego modelu sprawdzaliśmy, czy w danej dziedzinie radzi sobie lepiej, czy gorzej niż średnio u siebie. Jeśli model ma +40 w programowaniu i −30 w pisaniu kreatywnym, to wyraźnie ciąży w stronę kodu – bez względu na to, jak mocny jest ogólnie.
5. Luka. Dziedziny podzieliliśmy na dwie grupy:
- Sprawdzalne – programowanie, oprogramowanie i IT, matematyka oraz zadania branżowe oparte na matematyce. Da się zweryfikować, czy odpowiedź jest poprawna.
- Otwarte – pisanie kreatywne, pisanie i literatura oraz rozrywka i media. Nie ma jednej dobrej odpowiedzi; ocenić może tylko człowiek.
Luka to różnica między tym, jak model radzi sobie w grupie sprawdzalnej, a tym, jak radzi sobie w otwartej. Liczymy ją w punktach rankingu Areny. Żeby dać wyobrażenie o skali: przewaga 100 punktów oznacza, że model wygrywa mniej więcej 64 na 100 pojedynków.
6. Trend. Każdy model umieściliśmy na osi czasu według daty, w której pojawił się w rankingu. Potem sprawdziliśmy, czy nowsze modele mają większą lukę niż starsze.
7. Z punktów na miesiące. „80 punktów” niewiele mówi. Przeliczyliśmy to więc na czas. W programowaniu ranking nowych modeli rośnie o około 118 punktów rocznie. Jeśli pisanie kreatywne jest 80 punktów za programowaniem, to znaczy, że jest tam, gdzie programowanie było jakieś osiem miesięcy temu. Stąd „osiem miesięcy opóźnienia”.
8. Na ile to pewne. Niektóre firmy wypuszczają wiele modeli i są one do siebie podobne. Żeby jedna firma nie zdominowała wyniku, powtórzyliśmy całe obliczenie 2000 razy, za każdym razem losując, które firmy biorą w nim udział. Mówimy, że luka „rośnie” albo „maleje”, tylko wtedy, gdy zgadza się z tym co najmniej 95% powtórzeń. W pozostałych przypadkach piszemy „nie da się rozstrzygnąć”.
9. Dodatkowe testy. Sprawdziliśmy też, czy wynik nie jest przypadkowym efektem metody:
- Widać go w obrębie każdej firmy – nie wynika z tego, że na rynek weszli nowi gracze z innymi mocnymi stronami.
- Pojawia się w każdym z 95–180 sprawdzonych stanów rankingu z ostatnich dwóch lat.
- Utrzymuje się po usunięciu z danych dowolnej firmy.
- Przeprowadziliśmy też analizę bez naszego podziału na grupy. Pozwoliliśmy, by sama statystyka znalazła główną oś, wzdłuż której modele się od siebie różnią. Wyszedł ten sam podział: zadania sprawdzalne po jednej stronie, otwarte po drugiej. I ta oś niemal dokładnie pokrywa się z kierunkiem, w którym modele zmieniają się w czasie.
Co wyszło
Wszystko idzie w górę, ale luka rośnie
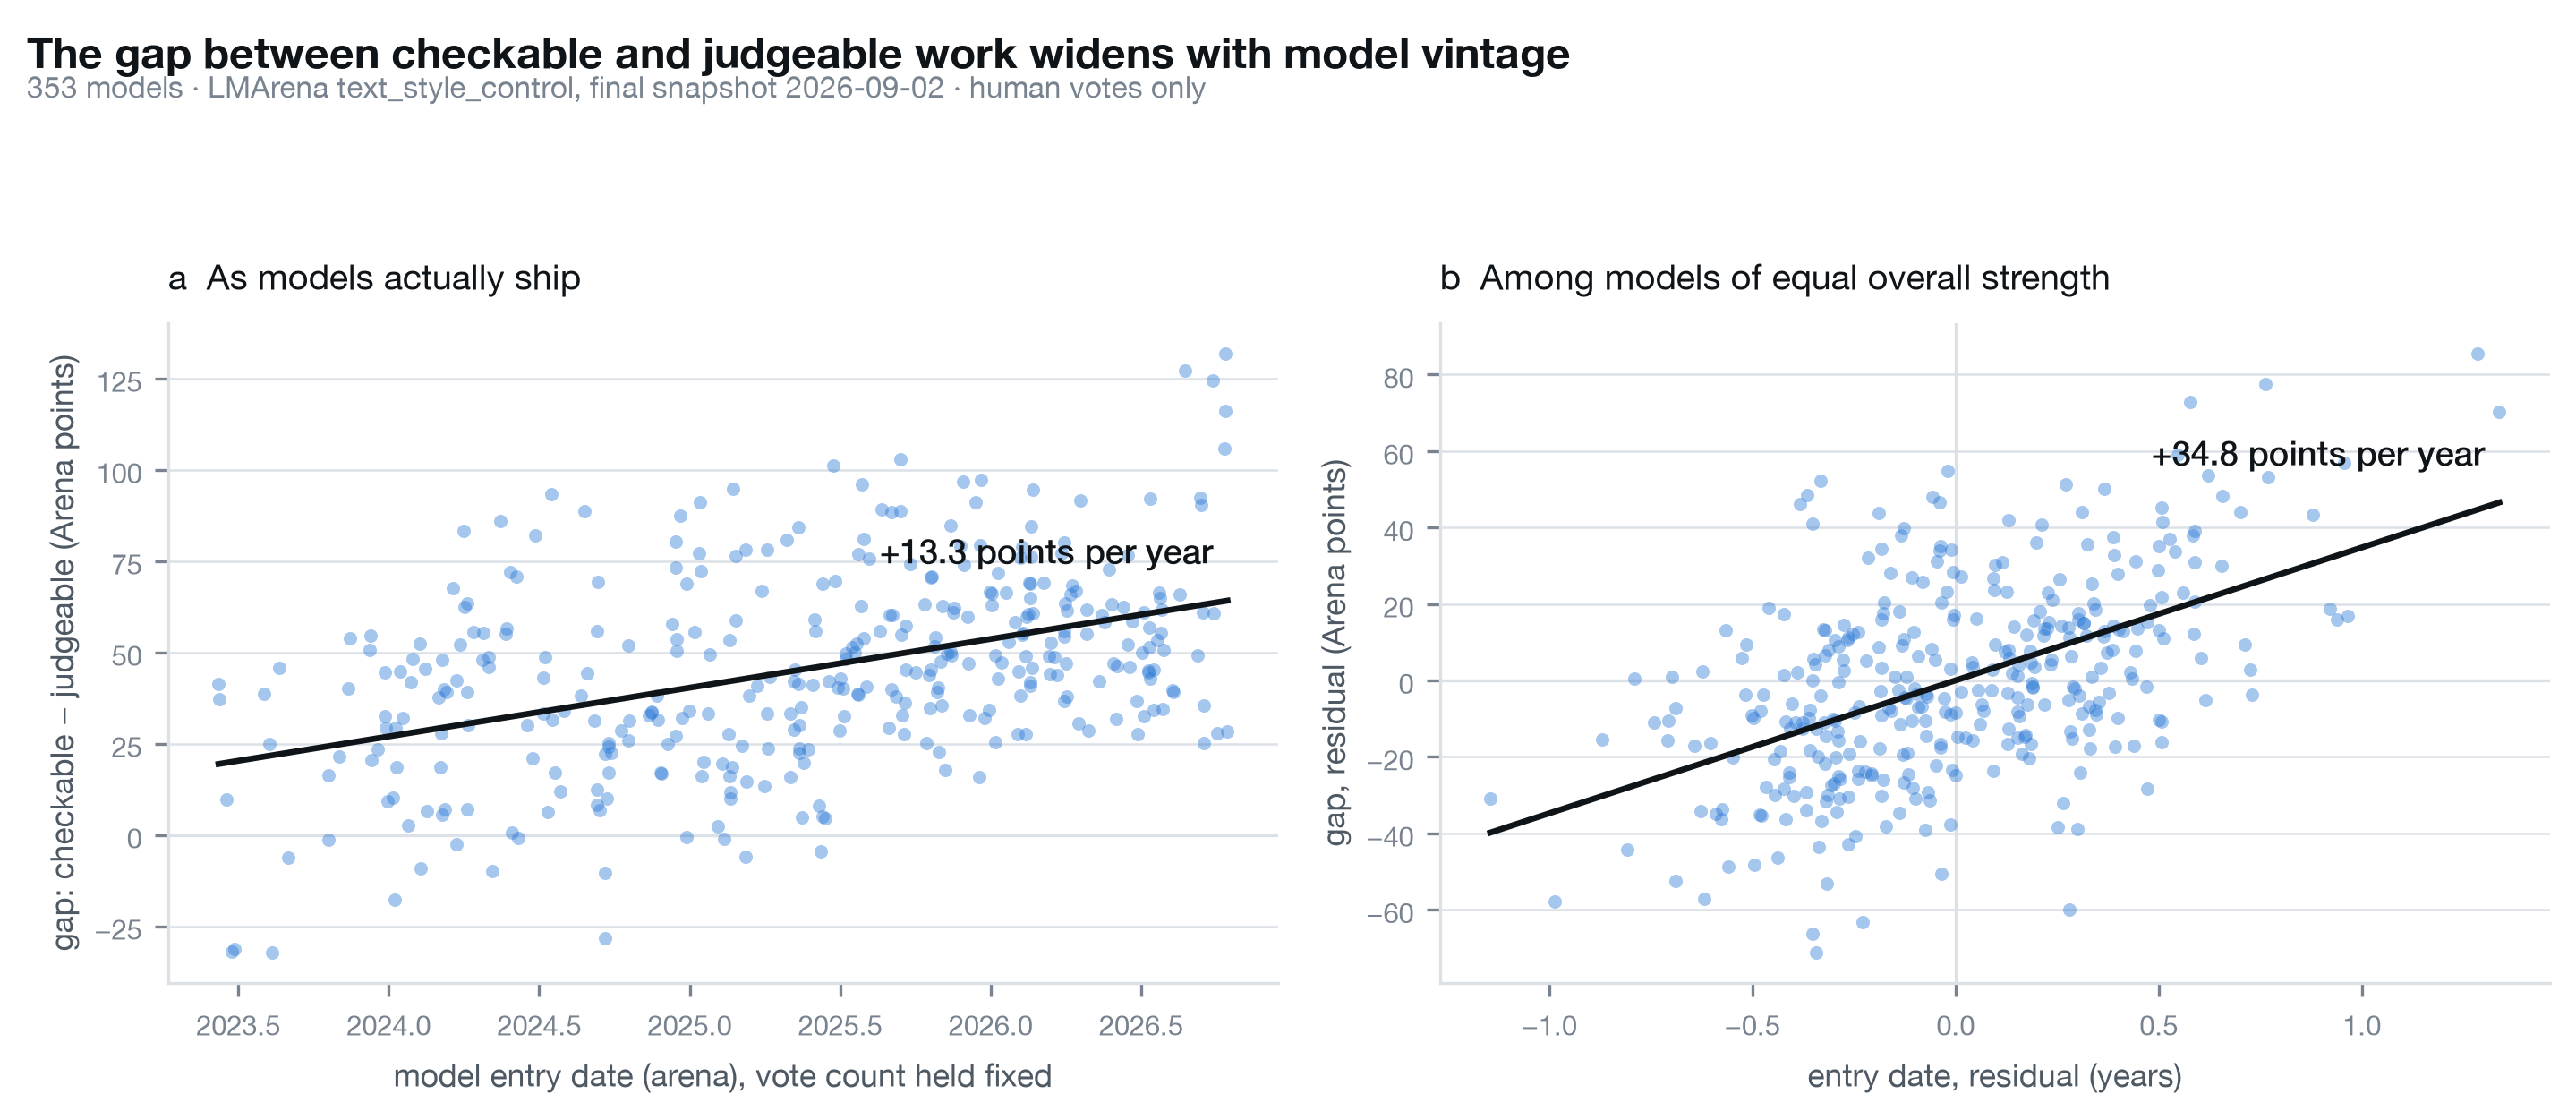
Każda kropka to jeden model. Im nowszy model (dalej na prawo), tym większa luka. Licząc po prostu kolejne premiery, rośnie ona o mniej więcej 13 punktów rocznie (wykres po lewej).
Prawy wykres odpowiada na bardziej precyzyjne pytanie: jeśli weźmiemy modele o tej samej ogólnej sile, to które mocniej ciążą w stronę zadań sprawdzalnych? Nowsze – o około 35 punktów rocznie. Innymi słowy, z każdym nowym modelem coraz większa część wysiłku producentów trafia w zadania, które da się sprawdzić.
Ważne zastrzeżenie: to nie jest regres. W liczbach bezwzględnych każda dziedzina rośnie z roku na rok. Pisanie kreatywne zyskuje około 106 punktów rocznie, programowanie około 118. Modele piszą coraz lepiej – tylko programują lepiej jeszcze szybciej.
Gdzie są dzisiejsze modele

Wykres zestawia modele z 2024 roku (puste kółka) z modelami z 2026 roku (pełne kółka). Kropka pokazuje, o ile modele w danej dziedzinie wypadają lepiej lub gorzej niż ich własna średnia.
Rzucają się w oczy trzy rzeczy:
- Programowanie i IT odskoczyły jeszcze bardziej. Już wcześniej były najmocniejszą stroną modeli, a teraz przewaga jest większa.
- Matematyka nadrobiła zaległości. W 2024 roku modele radziły sobie z nią gorzej niż średnio. W 2026 – lepiej.
- Wyraźnie osłabło doradztwo prawne i administracyjne. Modele z 2024 roku wypadały w pytaniach prawnych 25 punktów powyżej własnej średniej. Modele z 2026 roku – już tylko 7. To nadal ich mocna strona, ale coraz słabsza.
Wynik dotyczący prawa nas zaskoczył. Na początku zakładaliśmy, że chodzi o pieniądze: firmy rozwijają to, na czym da się zarobić. Tymczasem doradztwo prawne jest bardzo dochodowe, a mimo to zostaje w tyle. Lepiej wyjaśnia to podział z pierwszego wykresu: czy da się to sprawdzić. Nie ma testu, który powie, czy porada prawna jest trafna. Tak samo jak nie ma testu na dobre opowiadanie.
Pisanie ma osiem miesięcy opóźnienia

Prawy wykres nie zawiera żadnej prognozy. Każdy rocznik modeli potraktowaliśmy jako osobną grupę i bezpośrednio zmierzyliśmy jego opóźnienie. Dla modeli z 2023 roku pisanie kreatywne było 5,5 miesiąca za programowaniem, potem 6,8, potem 7,4, a dla modeli z 2026 roku już 8,2 miesiąca. Rozrywka i media oraz pisanie i literatura zachowują się tak samo.
Jeśli więc ktoś twierdzi, że pisanie „zaraz dogoni” resztę, dane mówią co innego. Dystans rośnie mniej więcej o miesiąc rocznie.
Które dziedziny nadrabiają?

Ten sam test przeprowadziliśmy dla każdej dziedziny. Każdy odcinek pokazuje, ile miesięcy opóźnienia dana dziedzina dokłada co roku. Na prawo od zera – coraz większe zaległości. Na lewo – nadrabianie. Jeśli odcinek przecina zero, kierunku nie da się ustalić.
- 6 dziedzin coraz bardziej odstaje od programowania: prawo i administracja, pisanie i literatura, pisanie kreatywne, rozrywka i media, medycyna i zdrowie oraz nauki przyrodnicze i ścisłe.
- 2 nadrabiają: obie kategorie matematyczne. W obecnym tempie dogonią programowanie około 2031–2033 roku.
- W 2 nie da się tego rozstrzygnąć: oprogramowanie i IT (już teraz prawie na poziomie programowania) oraz biznes i finanse.
Dystans zmniejszają wyłącznie dziedziny sprawdzalne. Żadna z otwartych.
W samej czołówce luka stoi w miejscu

To istotny szczegół. Modele z każdego rocznika podzieliliśmy na 20 najlepszych i całą resztę.
- W czołowej dwudziestce luka między programowaniem a pisaniem od 2023 roku jest mniej więcej stała: około 57 punktów, czyli jakieś 6 miesięcy. Nie powiększa się (prawy górny wykres, niebieska linia).
- Poza czołówką luka szybko rośnie (pomarańczowa linia). Tańsze i mniejsze modele coraz mocniej stawiają na kod.
Najlepsze modele nie zostawiają więc pisania w tyle. Ale większość firm nie używa najlepszych modeli do wszystkiego – przy dużej skali sięga po tańsze. A właśnie w tańszych modelach jakość pisania słabnie najszybciej.
Dolny rząd wykresów pokazuje jeszcze jedno: jak bardzo liczy się wybór modelu. Wśród 20 najlepszych modeli z 2026 roku różnica między trafnym a chybionym wyborem wynosi około 31 punktów w programowaniu i około 44 punkty w pisaniu kreatywnym. Przy pisaniu dobór modelu ma więc 1,4 raza większe znaczenie niż przy kodzie. W programowaniu czołowe modele są praktycznie wymienne. W pisaniu – nie.
To dzieje się w każdej firmie z osobna

Może to po prostu efekt nowych firm, które weszły na rynek z innymi mocnymi stronami? Nie. Prześledziliśmy kolejne flagowe modele każdego producenta, wersja po wersji. Luka rośnie w 8 z 10 takich linii.
Dwa wyjątki są ciekawe. DeepSeek zaczynał jako model wyspecjalizowany w kodzie i z czasem stał się bardziej uniwersalny. Meta na wczesnym etapie mocno poprawiła jakość zwykłej rozmowy. W obu przypadkach modele przesunęły się w stronę zadań otwartych i luka się zmniejszyła. To dobra wiadomość dla naszej metody: nie nagradza ona automatycznie zasady „nowszy znaczy lepszy w kodzie”. Gdy producent poszerza profil modelu, miara to wychwytuje.
Wybór dostawcy ma największe znaczenie tam, gdzie modele są najsłabsze
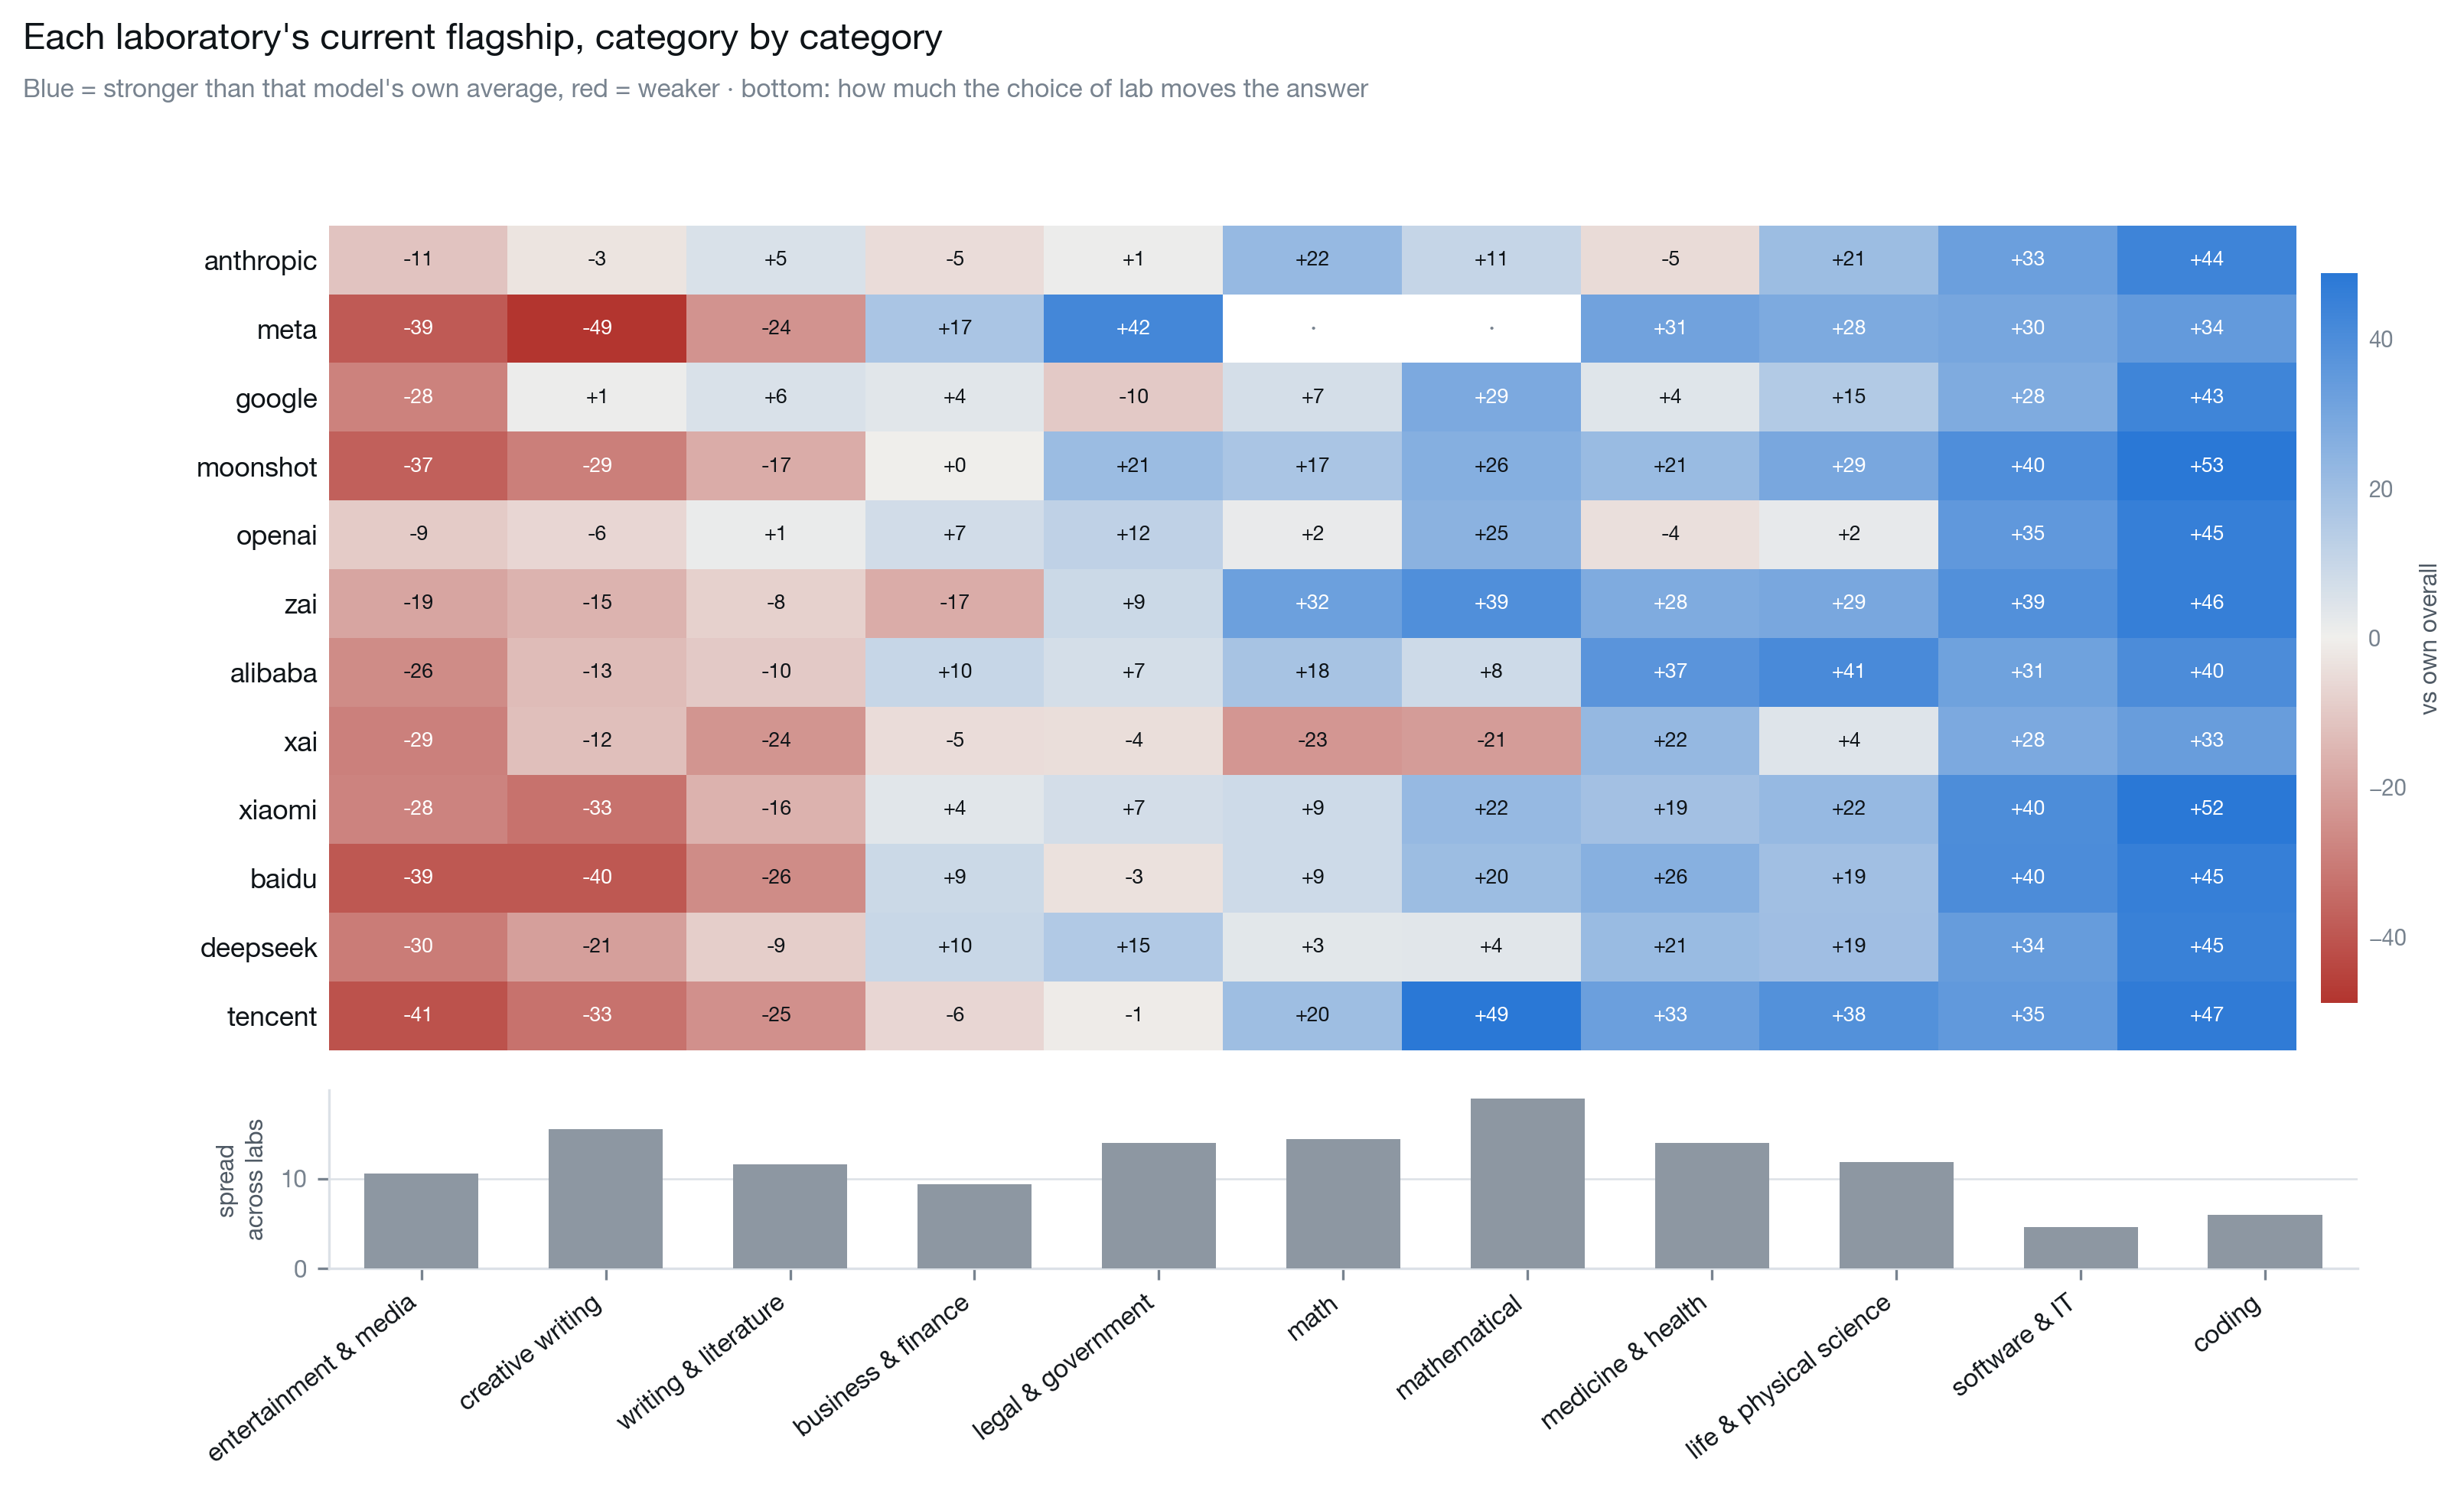
Każdy wiersz to obecny flagowy model jednej firmy. Kolor niebieski oznacza, że w danej dziedzinie model wypada lepiej niż jego własna średnia, czerwony – że gorzej.
Po prawej stronie widać, że wszyscy producenci są mocni w programowaniu i IT. Szare słupki pod spodem pokazują, jak bardzo wynik zależy od wyboru dostawcy. W programowaniu – prawie wcale.
Po lewej obraz jest zupełnie inny. W pisaniu kreatywnym rozrzut sięga od −49 (Meta) do +1 (Google). W prawie i administracji od −10 do +42. To dziedziny, w których modele są najsłabsze, a jednocześnie najbardziej się od siebie różnią. Tam, gdzie AI jest słabe, jest też nieprzewidywalne. I właśnie tam nie warto kierować się ogólną opinią o modelu.
Co z tego wynika dla firm
1. „Lepszy model” nie znaczy „lepszy w Twoich zadaniach”. Nowe modele są oceniane głównie na zadaniach sprawdzalnych. Jeśli używasz AI do pisania, doradztwa, obsługi klienta albo czegokolwiek, co ocenia człowiek, spodziewaj się mniejszej poprawy, niż sugerują zapowiedzi.
2. Benchmarki tego nie pokażą. Dziewięć na dziesięć publicznych wyników dotyczy zadań sprawdzalnych. Nie dowiesz się z nich, jak model poradzi sobie z pracą otwartą – a to na niej zależy większości firm.
3. Testuj na własnych zadaniach, zwłaszcza przy tańszych modelach. Luka w pisaniu rośnie najszybciej właśnie w tańszych i mniejszych modelach, których firmy używają na co dzień. Zanim przejdziesz na tańszy model, sprawdź, jak radzi sobie z tekstami.
4. Przy kodzie wybór modelu ma mniejsze znaczenie, przy pisaniu – duże. W programowaniu czołowe modele są blisko siebie. W pisaniu i doradztwie różnica między dobrym a złym wyborem jest większa i dalej rośnie.
5. Sprawdzaj przy każdej aktualizacji. W ciągu dwóch lat doradztwo prawne przestało być wyraźną mocną stroną modeli. Model, który rok temu dobrze sprawdzał się w Twoich zadaniach, dziś może radzić sobie gorzej na tle innych.
Podsumowanie
AI staje się lepsze we wszystkim. Ale w tym, co łatwo sprawdzić, rozwija się znacznie szybciej. A narzędzia, którymi zwykle porównuje się modele, widzą tylko tę część.
Jeśli Twoje AI wykonuje pracę wymagającą oceny, potrzebujesz sposobu, żeby sprawdzić właśnie tę pracę. Tym się zajmujemy.
Zastrzeżenia: to głosy ludzi w rozmowie z czatem, a nie wyniki prawdziwej pracy; rankingi są względne i opisują model na tle innych modeli z tego samego okresu; użytkownicy sami wybierają, o co pytają; większość wyników pochodzi z jednego źródła (LMArena); a daty w rodzaju „2031” zakładają, że obecny trend się utrzyma.